কোডিং সিস্টেম: BCD, ASCII, EBCDIC ও ইউনিকোড
এইচএসসি আইসিটি অধ্যায় ৩: বিভিন্ন কোডিং সিস্টেম যেমন BCD, ASCII, EBCDIC এবং Unicode এর বিস্তারিত আলোচনা। বাংলা ভাষায় কম্পিউটিং এর জন্য ইউনিকোডের গুরুত্ব।
কোডিং সিস্টেম: BCD, ASCII, EBCDIC ও ইউনিকোড
- কোডিং সিস্টেম: BCD, ASCII, EBCDIC ও ইউনিকোড
- তুমি তো 'A' চাপলে, কম্পিউটার কী বুঝল?
- কোড (Code) আসলে কী?
- BCD কোড (Binary Coded Decimal)
- BCD কোডে রূপান্তর উদাহরণ
- সতর্কতা: BCD এবং বাইনারি এক নয়!
- আলফানিউমেরিক কোড: শুধু সংখ্যা যথেষ্ট নয়
- ASCII কোড (অ্যাস্কি)
- EBCDIC কোড
- সমস্যা: কম্পিউটারে বাংলা লিখব কীভাবে?
- সমাধান: ইউনিকোড (Unicode - Universal Code)
- এক নজরে তুলনা: BCD, ASCII, EBCDIC ও Unicode
- সারাংশ ও বাড়ির কাজ
কোডিং সিস্টেম: BCD, ASCII, EBCDIC ও ইউনিকোড
কম্পিউটার বা ডিজিটাল ডিভাইস শুধুমাত্র ০ এবং ১—এই দুটি সিগন্যাল বুঝতে পারে। কিন্তু আমরা মানুষরা কথা বলি বাংলা, ইংরেজি বা অন্যান্য ভাষায়; ব্যবহার করি অংক (০-৯), বর্ণ (অ-ঔ, A-Z) এবং নানা চিহ্ন (!, @, #)। তাহলে মানুষের এই ভাষা কম্পিউটার কীভাবে বোঝে? এখানেই প্রয়োজন হয় কোডিং সিস্টেম (Coding System)।
মানুষের ব্যবহৃত বর্ণ, অংক বা চিহ্নগুলোকে কম্পিউটারের বোধগম্য যান্ত্রিক ভাষায় (Machine Language) অর্থাৎ ০ এবং ১ এর বিন্যাসে রূপান্তর করার প্রক্রিয়াকে বলা হয় এনকোডিং (Encoding)। আবার কম্পিউটারের প্রসেস করা ফলাফলকে মানুষের বোধগম্য ভাষায় ফিরিয়ে আনার প্রক্রিয়াকে বলা হয় ডিকোডিং (Decoding)।
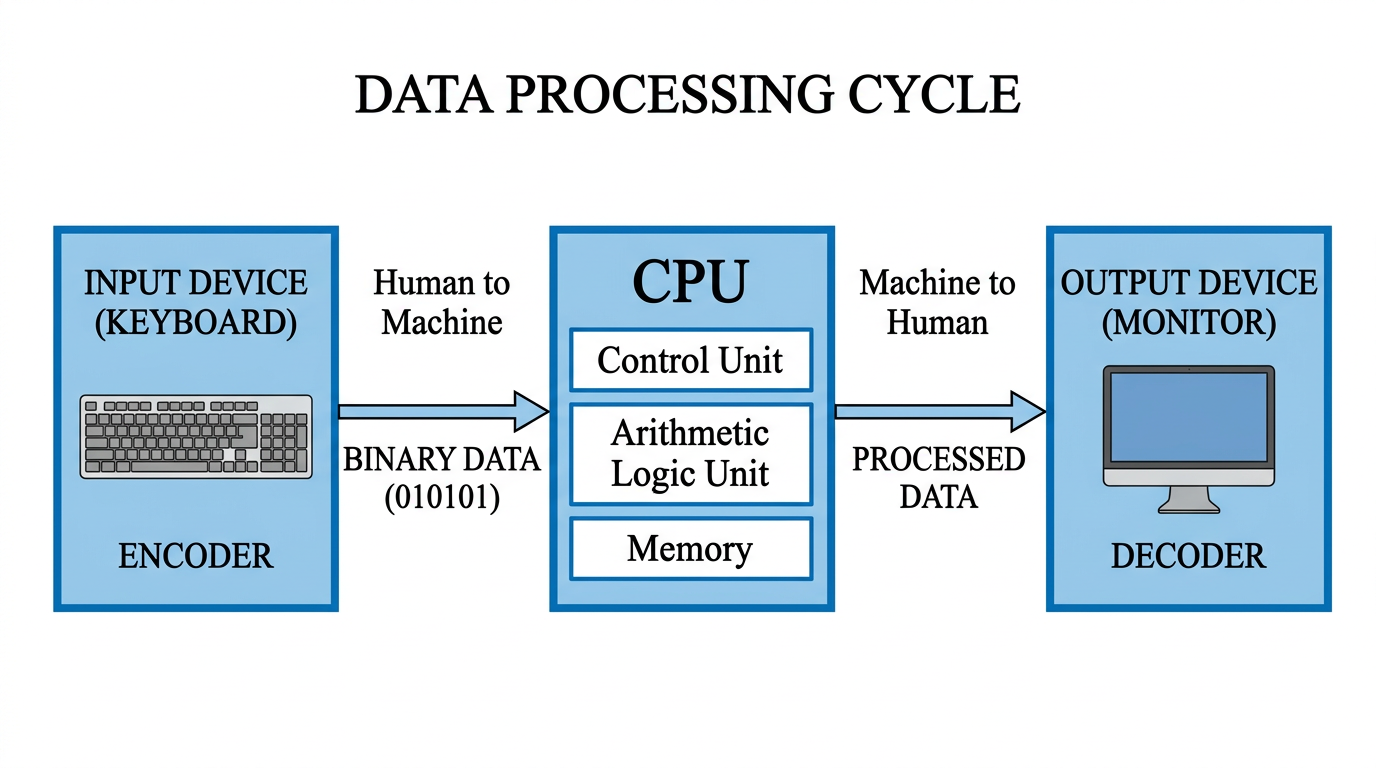
সংজ্ঞা (Definition): কোড (Code)
কম্পিউটার সিস্টেমে ডেটা প্রসেসিংয়ের জন্য ব্যবহৃত বর্ণ, অংক বা বিশেষ চিহ্নগুলোকে সিপিইউ-এর (CPU) বোধগম্য বাইনারি বিন্যাসে (০ এবং ১) অদ্বিতীয়ভাবে (Uniquely) উপস্থাপন করার জন্য যে সংকেত ব্যবহার করা হয়, তাকে কোড বলে।
মনে রাখবে: এনকোডিং ইনপুট ডিভাইসের (যেমন: কীবোর্ড) কাজ, যা মানুষের ভাষাকে মেশিনের ভাষায় রূপান্তর করে। আর ডিকোডিং আউটপুট ডিভাইসের (যেমন: মনিটর, প্রিন্টার) কাজ, যা মেশিনের ভাষাকে মানুষের ভাষায় রূপান্তর করে।
BCD কোড (Binary Coded Decimal): সংখ্যার সহজ রূপান্তর
BCD এর পূর্ণরূপ হলো Binary Coded Decimal। এটি কোনো সংখ্যা পদ্ধতি (Number System) নয়, বরং এটি দশমিক সংখ্যাকে বাইনারিতে রূপান্তর করার একটি বিশেষ কোডিং পদ্ধতি। দশমিক পদ্ধতির প্রতিটি অংককে (০-৯) সমতুল্য ৪-বিট বাইনারি মান দ্বারা প্রতিস্থাপন করে BCD কোড গঠন করা হয়।
BCD কোডের বিভিন্ন সংস্করণ রয়েছে (যেমন: Excess-3, 5421), তবে BCD-8421 হলো সবচেয়ে জনপ্রিয় এবং বহুল ব্যবহৃত পদ্ধতি। একে 'ন্যাচারাল BCD' ও বলা হয়।
গুরুত্বপূর্ণ (Important):
- BCD কোনো পজিশনাল সংখ্যা পদ্ধতি নয়।
- এতে প্রতিটি দশমিক অংকের জন্য ঠিক ৪টি করে বিট প্রয়োজন হয়।
- ০ থেকে ৯ পর্যন্ত অংকগুলোর জন্য BCD কোড এবং বাইনারি মান একই, কিন্তু ৯ এর পরের সংখ্যাগুলোর জন্য তা ভিন্ন।
- ১০১০ থেকে ১১১১ পর্যন্ত ৬টি বিন্যাস BCD তে ব্যবহার করা হয় না, এদেরকে অবৈধ কোড (Invalid Code) বলা হয়।
উদাহরণ ও ব্যাখ্যা
ধরি, একটি দশমিক সংখ্যা $(75)_{10}$। একে BCD তে রূপান্তর করতে হলে ৭ এবং ৫ কে আলাদাভাবে ৪ বিটের বাইনারিতে লিখতে হবে।
উদাহরণ ১: $(75)_{10}$ এর BCD কোড নির্ণয়
আমরা জানি,
$7 = 0111$ (৪ বিটে)
$5 = 0101$ (৪ বিটে)
সুতরাং, $(75)_{10} = (01110101)_{BCD}$
উদাহরণ ২: $(92)_{10}$ এর BCD কোড নির্ণয়
$9 = 1001$
$2 = 0010$
সুতরাং, $(92)_{10} = (10010010)_{BCD}$
সতর্কতা: বাইনারি সংখ্যা এবং BCD কোড এক নয়
শিক্ষার্থীরা প্রায়ই বাইনারি রূপান্তর এবং BCD কোডিংকে গুলিয়ে ফেলে। মনে রাখতে হবে, বাইনারি হলো একটি সংখ্যার গাণিতিক মান, আর BCD হলো অংকগুলোর সরাসরি প্রতিস্থাপন।
মেমোরি অপচয়ের প্রমাণ
নিচের উদাহরণটি লক্ষ্য করলে দেখা যাবে BCD তে একই সংখ্যা প্রকাশ করতে বেশি মেমোরি লাগে।
গাণিতিক প্রমাণ: $(25)_{10}$ এর ক্ষেত্রে
বাইনারি রূপান্তর: $(25)_{10} = (11001)_2$
এখানে মাত্র ৫টি বিট প্রয়োজন।
BCD রূপান্তর: $2 \rightarrow 0010, 5 \rightarrow 0101$
সুতরাং, $(25)_{10} = (00100101)_{BCD}$
এখানে মোট ৮টি বিট প্রয়োজন।
সিদ্ধান্ত: BCD কোড বাইনারি সংখ্যার চেয়ে বেশি বিট ব্যবহার করে, তাই এতে মেমোরি অপচয় হয়।
আলফানিউমেরিক কোড এবং ASCII
শুধুমাত্র সংখ্যা দিয়ে কম্পিউটারের সব কাজ করা সম্ভব নয়। আমাদের বর্ণ (a-z, A-Z), গাণিতিক চিহ্ন (+, -, =), এবং বিশেষ চিহ্ন (!, ?, @) প্রয়োজন হয়। অক্ষর, অংক এবং বিভিন্ন গাণিতিক ও বিশেষ চিহ্নসহ কীবোর্ডের সকল কি (Key) কে কম্পিউটারে ব্যবহারের জন্য যে কোড ব্যবহৃত হয়, তাকে আলফানিউমেরিক কোড (Alphanumeric Code) বলে। ASCII এবং EBCDIC হলো জনপ্রিয় আলফানিউমেরিক কোড।
ASCII (American Standard Code for Information Interchange)
১৯৬৫ সালে রবার্ট বিমার (Robert Bemer) এই কোড উদ্ভাবন করেন। এটি বর্তমানে বিশ্বের অন্যতম জনপ্রিয় কোডিং সিস্টেম। ASCII কোড দুই ধরনের হয়:
- ASCII-7: ৭ বিটের কোড। এতে $2^7 = 128$ টি চিহ্ন অদ্বিতীয়ভাবে নির্দিষ্ট করা যায়। বাম দিকের ১টি বিট প্যারিটি বিট হিসেবে ব্যবহৃত হয় (যদি ৮ বিট রেজিস্টার হয়)।
- ASCII-8: ৮ বিটের কোড। এতে $2^8 = 256$ টি চিহ্ন নির্দিষ্ট করা যায়। বর্তমানে এটিই বেশি ব্যবহৃত হয়।
ASCII কোডের গঠন:
ASCII কোডের ৮টি বিটকে সাধারণত দুটি অংশে ভাগ করা হয়:
- প্যারিটি বিট (Parity Bit): ১টি বিট (ভুল সনাক্তকরণের জন্য)।
- জোন বিট (Zone Bit): ৩টি বিট।
- নিউমেরিক বিট (Numeric Bit): ৪টি বিট।
প্যারিটি বিট (Parity Bit):
ডেটা আদান-প্রদানের সময় কোনো ভুল (Error) হয়েছে কি না, তা যাচাই করার জন্য মূল কোডের সাথে যে অতিরিক্ত একটি বিট (০ বা ১) জুড়ে দেওয়া হয়, তাকে প্যারিটি বিট বলে। এটি দুই প্রকার: জোড় প্যারিটি (Even Parity) ও বিজোড় প্যারিটি (Odd Parity)।
MCQ-তে প্রায়ই নির্দিষ্ট অক্ষরের ASCII মান জানতে চাওয়া হয়। নিচের মানগুলো মনে রাখা জরুরি: - **'A' থেকে 'Z' (বড় হাতের):** ৬৫ থেকে ৯০ - **'a' থেকে 'z' (ছোট হাতের):** ৯৭ থেকে ১২২ - **'0' থেকে '9' (অংক):** ৪৮ থেকে ৫৭ - **Space (ফাঁকা স্থান):** ৩২
*টিপস: বড় হাতের অক্ষরের সাথে ৩২ যোগ করলে ছোট হাতের অক্ষরের মান পাওয়া যায়। যেমন: A(65) + 32 = a(97)।*
EBCDIC কোড: মেইনফ্রেমের ভাষা
EBCDIC এর পূর্ণরূপ হলো Extended Binary Coded Decimal Interchange Code। এটি ৮ বিট বিশিষ্ট একটি আলফানিউমেরিক কোড।
সংজ্ঞা:
IBM কোম্পানি তাদের মেইনফ্রেম এবং মিনি কম্পিউটারে ব্যবহারের জন্য যে ৮-বিটের কোডিং সিস্টেম চালু করে, তাকে EBCDIC কোড বলে। এতে $2^8 = 256$ টি ভিন্ন ভিন্ন ক্যারেক্টার বা চিহ্ন প্রকাশ করা যায়।
বর্তমানে মাইক্রোকম্পিউটার বা পিসিতে এর ব্যবহার প্রায় নেই বললেই চলে। এতে ০-৯ অংকগুলোর জোন বিট হিসেবে সবগুলোতে 1111 ব্যবহার করা হয়।
ইউনিকোড (Unicode): ভাষার সীমানা বিলুপ্তি
কম্পিউটার প্রযুক্তির শুরুর দিকে শুধু ইংরেজি ভাষা প্রাধান্য পেত (ASCII দিয়ে)। কিন্তু বিশ্বের অন্যান্য ভাষা (যেমন: বাংলা, আরবি, চাইনিজ) কম্পিউটারে ব্যবহারের জন্য ASCII বা EBCDIC যথেষ্ট ছিল না। এই সমস্যা সমাধানের জন্য অ্যাপল এবং জেরক্স কর্পোরেশনের একদল প্রকৌশলী ১৯৯১ সালে ইউনিকোড কনসোর্টিয়াম গঠন করেন এবং Unicode উদ্ভাবন করেন।
সংজ্ঞা (Unicode):
বিশ্বের ছোট-বড় সকল ভাষাকে কম্পিউটারে কোডভুক্ত করার জন্য যে ১৬ বিটের (বর্তমানে ৩২ বিটও হয়) কোড ব্যবহৃত হয়, তাকে ইউনিকোড বা Universal Code বলে।
ইউনিকোডের বৈশিষ্ট্য ও গুরুত্ব
- ধারণক্ষমতা: ইউনিকোড মূলত ১৬ বিটের কোড। ফলে এতে $2^{16} = 65,536$ টি অদ্বিতীয় চিহ্ন প্রকাশ করা যায়। বর্তমানে এর পরিধি আরও বেড়েছে।
- ভাষার অন্তর্ভুক্তি: বাংলা, আরবি, গ্রিক, ল্যাটিন, চাইনিজ, জাপানিজসহ বিশ্বের প্রায় সব ভাষার লিপি এবং ইমোজি (Emoji) ইউনিকোডের অন্তর্ভুক্ত।
- বাংলা ভাষা: আমাদের বাংলা ভাষার কম্পিউটিং (যেমন: অভ্র, বিজয় ৫২ এর আধুনিক সংস্করণ) ইউনিকোডের কারণেই এত সহজ হয়েছে।
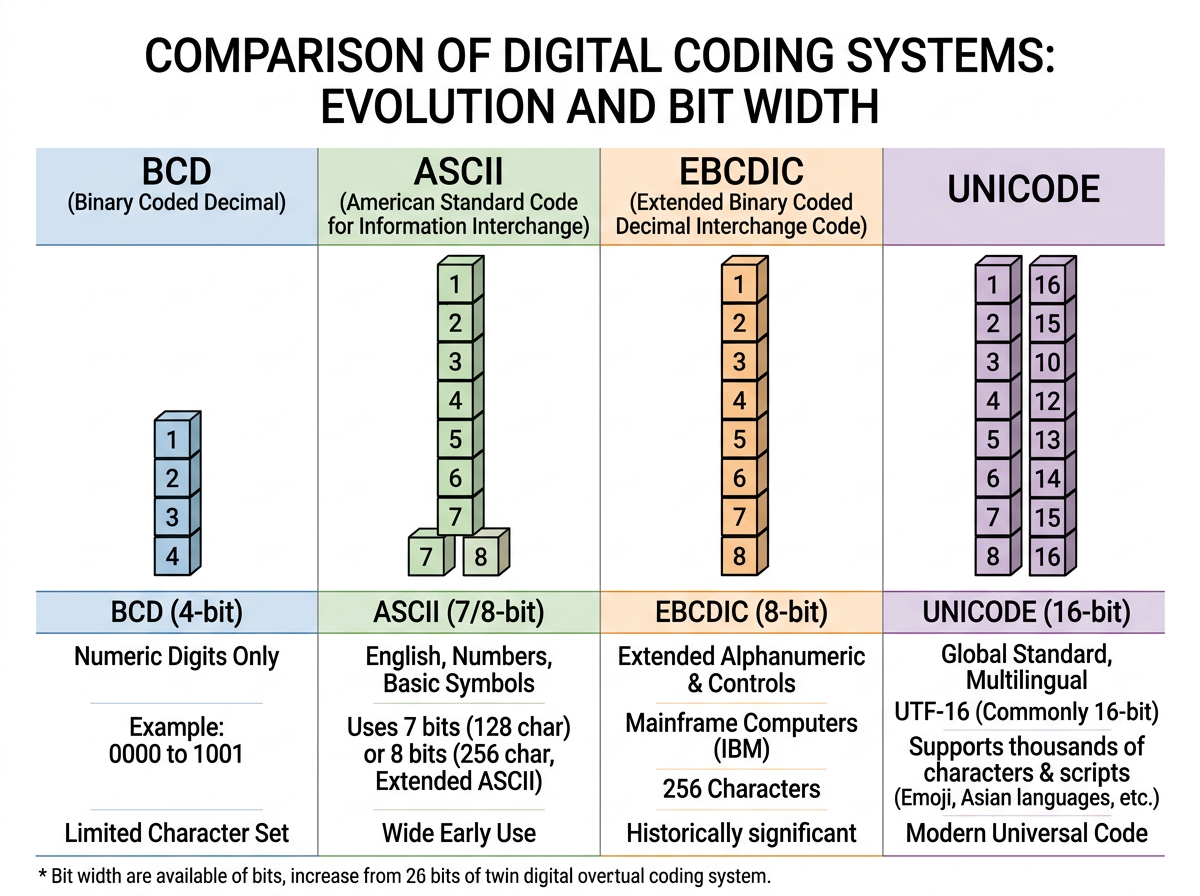
সংক্ষিপ্ত সারাংশ (Quick Revision)
রিভিশন চেকলিস্ট:
- BCD: সংখ্যা পদ্ধতি নয়, দশমিকের বাইনারি কোড। ৪ বিট লাগে।
- ASCII: ৭ বা ৮ বিটের কোড। ইংরেজি ভাষার জন্য আদর্শ। A=65, a=97, 0=48।
- EBCDIC: ৮ বিটের কোড। IBM মেইনফ্রেমে ব্যবহৃত হয়।
- Unicode: ১৬ বিটের কোড। বিশ্বের সকল ভাষার জন্য।
- প্যারিটি বিট: ভুল সংশোধনের জন্য ব্যবহৃত অতিরিক্ত ১টি বিট।
পরীক্ষার টিপস (Exam Tip):
সৃজনশীল প্রশ্নে যদি "বিশ্বের সকল ভাষাকে কম্পিউটারে ব্যবহারের উপযোগী কোড" নিয়ে উদ্দীপক থাকে, তবে চোখ বন্ধ করে ইউনিকোড নিয়ে লিখবে। আর যদি পার্থক্য লিখতে বলে, তবে অবশ্যই 'বিটের সংখ্যা', 'মোট চিহ্ন সংখ্যা' এবং 'ব্যবহার'—এই তিনটি পয়েন্ট উল্লেখ করবে।
পরিভাষা (Glossary)
| পরিভাষা (Term) | সংজ্ঞা (Definition) |
|---|---|
| এনকোডিং (Encoding) | মানুষের ভাষাকে কম্পিউটারের বোধগম্য যান্ত্রিক ভাষায় রূপান্তরের প্রক্রিয়া। |
| ডিকোডিং (Decoding) | কম্পিউটারের যান্ত্রিক ভাষাকে মানুষের বোধগম্য ভাষায় রূপান্তরের প্রক্রিয়া। |
| আলফানিউমেরিক কোড | যে কোড দ্বারা অক্ষর, অংক এবং বিভিন্ন গাণিতিক ও বিশেষ চিহ্ন প্রকাশ করা যায়। |
| প্যারিটি বিট | ডেটা আদান-প্রদানে ভুল সনাক্ত করার জন্য যুক্ত অতিরিক্ত বিট। |
| বিট (Bit) | বাইনারি ডিজিট (0 বা 1)। |
| অবৈধ কোড (Invalid Code) | BCD-তে ১০১০ থেকে ১১১১ পর্যন্ত ৬টি অব্যবহৃত বিন্যাস। |